

IAConSentido · Guías y fuentes externas · Por Karine Boucher
“Este modelo es mejor”. Cuando escucho esa frase, mi primera pregunta es: ¿mejor para qué? Puede responder con más aciertos en una prueba y fallar justo en la tarea que necesitas. Te recomiendo mirar cómo se hizo la comparación antes de elegir por una posición en una tabla.
Qué propone Holistic Evaluation of Language Models
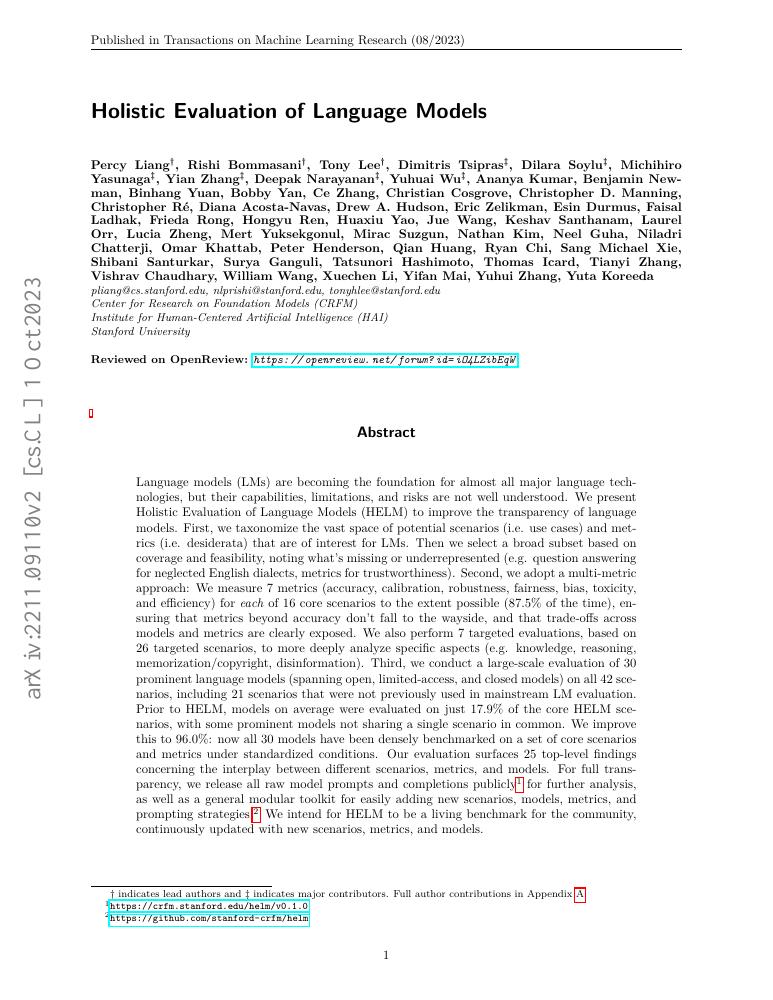
Holistic Evaluation of Language Models, conocido como HELM, es un trabajo de Percy Liang y coautores del Stanford CRFM. Presentado en 2022 y revisado en octubre de 2023, propone comparar modelos en escenarios y métricas comunes, haciendo visibles las limitaciones de la evaluación.
El trabajo examina dimensiones como acierto, calibración, robustez, equidad, sesgos, toxicidad y eficiencia. Aquí me refiero a ese estudio, no a un ranking actualizado de modelos. Su aportación útil para esta conversación es evitar que una sola medida oculte diferencias importantes.
Elige primero qué error necesitas detectar
Yo empezaría por describir qué resultado sería problemático para las personas que van a usar la herramienta. No es lo mismo equivocarse al proponer un título que omitir una condición en una respuesta sobre una solicitud.
Una evaluación útil también debe dejar espacio para “no lo sabemos”. Si una prueba no incluye tu idioma, tu tipo de documento o una situación difícil, no conviertas esa ausencia en una garantía.
Ejemplo ficticio: responde rápido, pero cambia el sentido
Imagina que comparas 2 asistentes para resumir mensajes de clientes. Uno termina antes y escribe de forma más clara. Al revisar los ejemplos, descubres que a veces transforma una pregunta en una afirmación. El otro tarda más, pero conserva mejor esa diferencia.
¿Cuál elegirías? Yo no decidiría solo por la velocidad. Primero revisaría qué consecuencias tendría enviar un resumen incorrecto a la persona que resolverá el caso, cuánto cuesta corregirlo y qué control humano puedes mantener.
El ejemplo es mío y no reproduce un resultado de HELM. Sirve para mostrar por qué las prioridades deben estar claras antes de celebrar una puntuación.
Una prueba pequeña que puedes preparar
- Reúne casos representativos sin información personal innecesaria.
- Incluye algunos casos difíciles, no solo los que salen bien en una demostración.
- Define qué significa un resultado aceptable antes de compararlos.
- Registra los errores por tipo, no únicamente un promedio.
- Anota versión, fecha y condiciones para poder repetir la prueba.
No es una implementación de la metodología completa de HELM. Es una forma de empezar una conversación más precisa con quienes sí harán la evaluación técnica. Si el uso puede afectar derechos, seguridad o acceso a servicios, una prueba informal no basta para aprobarlo.
Qué familias de riesgos humanos relaciono
Cognición y criterio: confundir una puntuación con una conclusión válida para cualquier tarea. Decisiones, organizaciones y sociedad: elegir herramientas sin considerar a quienes sufrirían un error. Esta relación pertenece a mi Taxonomía IAConSentido, no a las métricas del estudio.
¿HELM certifica que un modelo es seguro?
No. Comparar resultados permite conocer algunas capacidades y limitaciones bajo ciertas condiciones. Te recomiendo conservar siempre la pregunta que una tabla no puede responder por ti: ¿qué necesitamos comprobar en nuestro caso antes de depender de este resultado?
Consultar Holistic Evaluation of Language Models · Explorar la Biblioteca de Riesgos Humanos de la IA
Fuente consultada el 13 de noviembre de 2026. Trabajo de 2022, revisión de octubre de 2023. Karine Boucher · Especialista en Riesgos Humanos de la IA · Creadora del Método SENSE.